
Widoczność w AI · 20 czerwca 2026
Dlaczego Twojej marki nie ma w ChatGPT, Perplexity i Gemini – 7 błędów (i jak je naprawić)
TL;DR
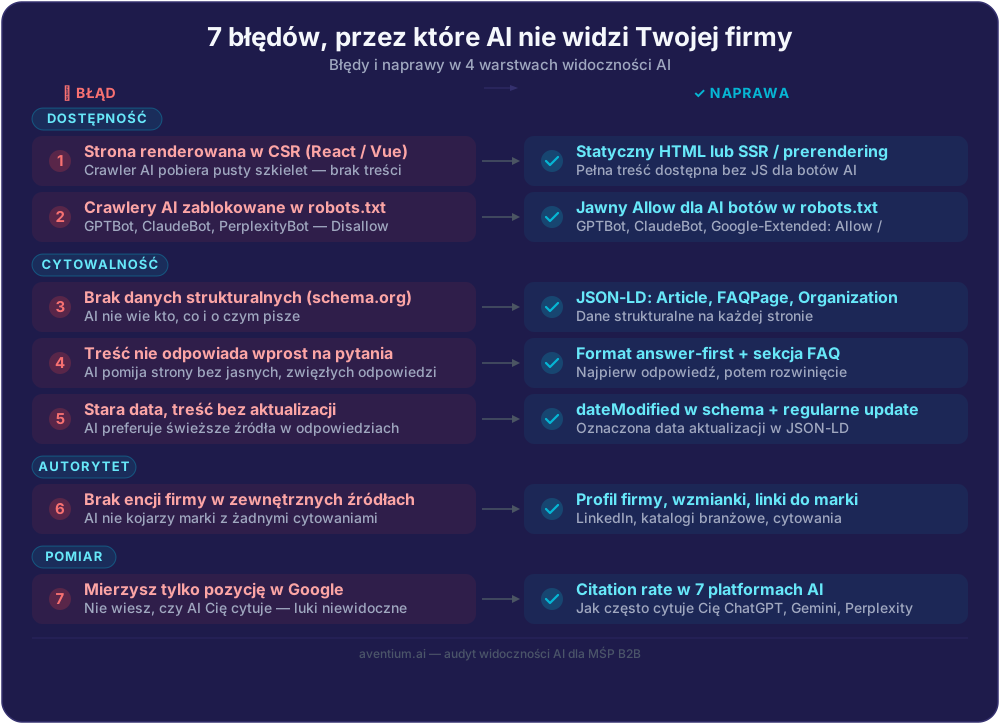
Marki rzadko są niewidoczne w AI z jakiegoś egzotycznego powodu: niemal zawsze sypie się jeden z kilku fundamentów. Poniżej 7 najczęstszych błędów i jak każdy naprawić, ułożonych w cztery warstwy: czy bot w ogóle wejdzie na stronę, czy zrozumie treść, czy ma autorytet, na którym oprze rekomendację, i czy mierzysz właściwą rzecz. Zacznijmy szczerze: przepuściliśmy własną stronę przez audyt widoczności w AI i dostaliśmy 12/92. Część z tych błędów popełniliśmy sami, dlatego wiemy, gdzie boli.
Dlaczego akurat Perplexity i Gemini działają inaczej niż ChatGPT?
Zanim przejdziemy do błędów, jedna rzecz, która tłumaczy połowę z nich: te trzy platformy oceniają Cię w zupełnie inny sposób.
Perplexity to wyszukiwarka „na żywo”: odwiedza strony w momencie zapytania i cytuje konkretne źródła z linkami. Faworyzuje strony szybkie, ustrukturyzowane i konkretne (fakty, liczby, jasne odpowiedzi). Strona wolna albo niedostępna w chwili crawl'u po prostu wypada z gry.
Gemini / Google AI Overviews to w praktyce nakładka na Google Search. Pozycja w wynikach jest tu bramą wejścia, dochodzą sygnały jakości strony (Core Web Vitals) i format „featured snippet”, zwięzła odpowiedź w 40–60 słowach, którą Google może wyciąć.
ChatGPT jest silniej oparty na pamięci z treningu modelu, dlatego marka bywa tam widoczna, mimo słabszej obecności gdzie indziej. Haczyk: to przewaga krucha. Kolejna wersja modelu może „zapomnieć”, a do treningu i tak trafia to, co jest publicznie czytelne na stronie. Platformy „na żywo” (Perplexity, AIO) są trudniejsze, ale bardziej stabilne.
Te same błędy uderzają w każdą z nich inaczej. I o tym jest reszta tekstu.
Warstwa 1. Dostępność: czy bot w ogóle wejdzie i przeczyta
Błąd 1: Strona renderowana po stronie przeglądarki (CSR)
Jeśli treść dokleja JavaScript dopiero w przeglądarce, bot AI często widzi pustą stronę: sam szkielet, bez treści do zacytowania. To najczęstszy i najdroższy błąd, bo unieważnia całą resztę pracy. Wiemy to z własnego podwórka: nasza pierwsza wersja strony była renderowana po stronie przeglądarki i w audycie widoczności w AI dostała 12/92. Po przejściu na statyczny HTML wynik wystrzelił.
Naprawa: treść musi być w HTML-u serwowanym od razu (statyczny HTML albo renderowanie po stronie serwera). Sprawdź to, pobierając stronę jako „surowy” dokument: jeśli nie widzisz w nim swojej treści, bot też jej nie widzi.
Błąd 2: Zablokowane lub niedostępne crawlery AI
Bot może nie wejść z kilku powodów: robots.txt blokuje GPTBot / ClaudeBot / PerplexityBot, treść jest za logowaniem albo za interakcją, albo (co coraz częstsze) blokuje go warstwa sieciowa. Od 1 lipca 2025 Cloudflare domyślnie blokuje crawlery AI dla nowych domen (źródło: komunikat Cloudflare, „Content Independence Day”), więc blokada potrafi być włączona, zanim w ogóle o niej wiesz, i działa niezależnie od tego, co masz w robots.txt.
Naprawa: w robots.txt jawnie dopuść zaufane boty AI; sprawdź ustawienia „AI bots / AI Crawl Control” u dostawcy CDN; przetestuj realny dostęp, pobierając stronę z nagłówkiem konkretnego bota. 200 znaczy „wpuszcza”, 403/challenge znaczy „blokuje”.
Warstwa 2. Cytowalność: czy treść da się zrozumieć i wyciąć
Błąd 3: Brak danych strukturalnych (schema)
Bez znaczników schema.org AI musi zgadywać, czym jest treść i czym jest Twoja firma. Schema podaje to wprost: typ treści, autora, organizację, pytania i odpowiedzi.
Naprawa: dodaj schema dopasowaną do strony (np. Article/BlogPosting, FAQPage, Organization). Uporządkowane pary pytanie–odpowiedź są dla AI trywialnie łatwe do wycięcia jako gotowa odpowiedź.
Błąd 4: Treść nie jest „answer-first”
Jeśli odpowiedź na pytanie użytkownika jest zakopana pod trzema akapitami wstępu, AI jej nie wytnie. Modele szukają samodzielnych fragmentów, które bez kontekstu odpowiadają na jedno pytanie.
Naprawa: wyciągnij odpowiedź na górę. Pod jasnym nagłówkiem (H2 sformułowanym jak pytanie) daj zwięzłą, samodzielną odpowiedź w 40–60 słowach. Resztę rozwiń niżej.
Błąd 5: Nieaktualna, nieodświeżana treść
Asystenci AI, zwłaszcza ChatGPT i Perplexity, faworyzują świeższe źródła. Według badania Ahrefs na ~17 mln cytowań (2025) treść cytowana przez AI jest średnio ~25,7% świeższa niż wyniki organiczne Google. Według raportu AirOps „2026 State of AI Search” strony nieaktualizowane ponad 3 miesiące mają ponad 3× większą szansę utraty cytowań AI. Stara, nieruszana strona po cichu wypada.
Uczciwie, żeby nie wpaść w hype: to skew, nie absolut. Treść cytowana przez AI i tak ma średnio ~2,9 roku, a autorytet i głębia często przeważają nad samą datą. Google AI Overviews jest tu wyjątkiem: cytuje treść w podobnym wieku co zwykłe wyniki Google, bez biasu świeżości (Ahrefs). I jedno: podmiana samej daty nie działa, liczy się realna aktualizacja treści.
Naprawa: ustal cykl odświeżania kluczowych stron (np. najważniejsze co kwartał) i rób prawdziwe zmiany: aktualne dane, nowe sekcje, poprawione liczby. W szybkozmiennych branżach to nie kosmetyka, tylko warunek utrzymania się w cytowaniach.
Warstwa 3. Autorytet: czy AI ma na czym oprzeć rekomendację
Błąd 6: Zerowy autorytet encji i brak weryfikowalnych dowodów
Nawet idealnie zoptymalizowana strona nie wystarczy, jeśli na zewnątrz nie istniejesz. AI buduje „zaufanie” do marki na podstawie rozpoznawalnych baz (Crunchbase, Wikidata) i wzmianek w niezależnych źródłach. Perplexity wprost ufa temu, co cytują inni. Jeśli o Twojej marce nikt nie pisze i nie ma jej w bazach, model nie ma na czym oprzeć rekomendacji.
Naprawa: zbuduj spójną encję (obecność w uznanych bazach, jednolite dane wszędzie) i zapracuj na wzmianki w wiarygodnych źródłach. Uwaga uczciwa: „dowody skuteczności” to realne wyniki, nie wymyślone case studies. Jeśli nie masz jeszcze portfela klientów, oprzyj się na tym, co prawdziwe (własne dane, audyty, publikacje), zamiast fabrykować referencje.
Warstwa 4. Pomiar: czy w ogóle mierzysz właściwą rzecz
Błąd 7: Mierzenie rankingu zamiast cytatu
Najbardziej podstępny błąd: patrzysz wyłącznie na pozycję w Google, a relacja między rankingiem a cytatem AI zależy od powierzchni. AI Overviews mocno opiera się na rankingu: według Ahrefs (analiza 1,9 mln cytowań) 86% cytowań AIO pochodzi ze stron w top 100 Google, a mediana pozycji cytowanego URL-a to 3. Ale asystenci to inna historia: w badaniu Ahrefs tylko ~12% cytowań asystentów (ChatGPT, Perplexity, Gemini, Copilot) rankuje w Google top 10, a 80% nie rankuje w ogóle dla danego zapytania; dla samego ChatGPT aż 28,3% najczęściej cytowanych stron ma zerową widoczność organiczną w Google. Czyli świetna pozycja pomaga w AIO, ale nie gwarantuje cytatu u asystenta, a „spadła mi widoczność” bywa po prostu zmianą mechanizmu, nie zniknięciem strony.
Naprawa: mierz cytowania i wzmianki w AI, nie samą pozycję. Ranking w Google to wciąż istotny sygnał (zwłaszcza dla AIO), ale jako jeden z wielu, nie jako jedyny licznik.
Tyle najczęstszych winowajców. Zauważ, że żaden z nich nie jest trikiem: to fundamenty. Dlatego dobra wiadomość jest taka, że wszystkie da się naprawić, jeśli zacznie się od właściwego.
Jeśli chcesz wiedzieć, który z tych błędów dotyczy akurat Twojej strony, robimy bezpłatne wstępne sprawdzenie widoczności w AI. Zobacz, jak działa.
FAQ
Dlaczego mojej marki nie ma w ChatGPT, Perplexity ani Gemini?
Najczęściej to nie jeden egzotyczny powód, tylko jeden z fundamentów: bot nie wchodzi na stronę (CSR, zablokowane crawlery), nie rozumie treści (brak schema, treść nie „answer-first”), albo marka nie ma autorytetu poza stroną (brak w bazach i wzmiankach). Każda z tych platform ocenia Cię inaczej, więc ten sam błąd uderza w nie z różną siłą.
Jak zwiększyć widoczność marki w Perplexity?
Perplexity crawluje na żywo i cytuje konkretne źródła, więc liczą się trzy rzeczy: dostępność i szybkość strony (wolna lub zablokowana wypada przy crawl'u), treść konkretna i „answer-first” (fakty, liczby, jasne odpowiedzi), oraz wzmianki w niezależnych źródłach. Perplexity ufa temu, co cytują inni. Świeżość też pomaga: to platforma z wyraźnym biasem na nowszą treść.
Moja widoczność w AI Search nagle spadła: co robić?
Najpierw sprawdź, czy to realny spadek, czy zmiana mechanizmu: powierzchnie AI i ranking Google nie mapują się 1:1 (Ahrefs: 80% cytowań asystentów nie rankuje w Google top 100 dla danego zapytania), więc „spadek” bywa złudzeniem pomiaru. Potem przejdź checklistę: czy boty AI nadal mają dostęp (CDN/robots.txt), czy nie pogorszyła się szybkość/CWV, czy treść nie zestarzała się bez odświeżenia, i czy konkurencja nie odświeżyła swojej. Mierz cytowania, nie samą pozycję.
Czy mała firma może konkurować w AI Search z dużymi markami?
Tak, bardziej niż w klasycznym SEO. AI faworyzuje treść konkretną, dobrze ustrukturyzowaną i odpowiadającą wprost na pytanie, a nie tylko największe domeny. Mała firma z głęboką, świeżą treścią na wąskim temacie i czystą encją realnie wygrywa cytowania z dużym, ale ogólnym graczem.
Dlaczego nie pojawiam się w odpowiedziach AI, skoro mam dobrą pozycję w Google?
Bo w asystentach ranking ≠ cytat. Według badania Ahrefs tylko ~12% cytowań asystentów (ChatGPT, Perplexity, Gemini, Copilot) rankuje w Google top 10, a 80% nie rankuje w ogóle dla danego zapytania: te modele używają innych sygnałów (struktura, cytowalność, świeżość, autorytet encji). Dobra pozycja w Google pomaga zwłaszcza w AI Overviews, które mocno opiera się na rankingu, ale nie gwarantuje cytatu u asystenta.
Czy potrzebuję pliku llms.txt, żeby AI mnie widziało?
Nie. Pięć niezależnych analiz (m.in. SE Ranking na ~300 000 domen) nie wykazało związku między llms.txt a cytowaniami, a Google i OpenAI go do tego nie używają (OpenAI odsyła do robots.txt). Plik nie zaszkodzi i bywa przydatny dla integracji agentowych, ale to nie dźwignia widoczności. Zamiast na nim, skup się na treści czytelnej na samej stronie.